Un sitio bilingüe en Next.js sin middleware
Cómo está hecho este sitio en inglés y español con el App Router de Next.js 16: rutas traducidas, una sola fuente para todas las URL, hreflang, sitemap, selector de idioma y ni una línea de middleware.
Jonás Javier Encarnación13 min de lectura
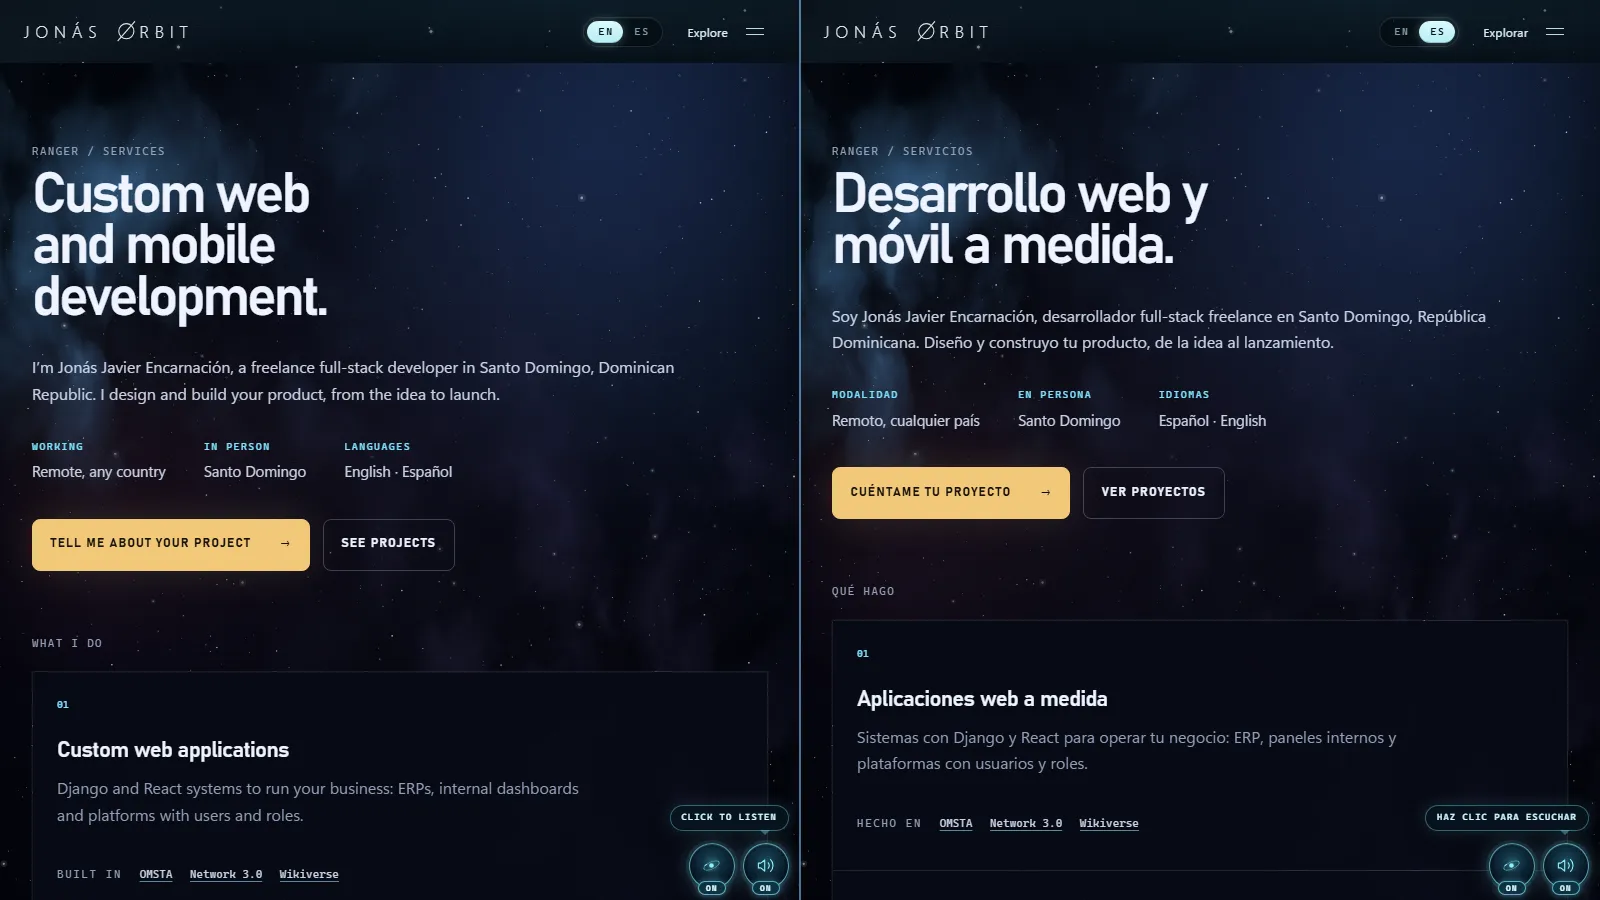
Este sitio está completo en inglés y en español. El inglés es el idioma por
defecto y el español está a un clic, en la cabecera. Cada página tiene su
propia dirección en cada idioma —/en/about y /es/sobre-mi, /en/contact y
/es/contacto— y Google sabe que son la misma página en dos idiomas, no dos
páginas que compiten entre sí.
Todo eso está hecho con el App Router de Next.js 16, sin librería de internacionalización y sin middleware. Esta entrada cuenta cómo, con el código real, y sobre todo por qué cada decisión es la que es.
Tres decisiones antes de escribir código
Cada idioma tiene su URL. Nada de servir el inglés o el español en la misma
dirección según quién pregunte. Una página que cambia según la cabecera
Accept-Language no se puede cachear de forma estable, no se puede enlazar
sabiendo qué verá el otro y, lo más importante para el posicionamiento, un
buscador siempre la rastrea en el mismo idioma. La otra mitad del sitio
desaparece del índice.
Las rutas se traducen. /es/sobre-mi y no /es/about. Quien busca en
español escribe en español, y la URL forma parte de lo que ve en el resultado.
Es más trabajo —una carpeta estática sólo puede llamarse de una manera— y la
mayor parte de esta entrada trata de cómo pagarlo una sola vez.
Un idioma por defecto, explícito. La raíz / lleva a /en, y el
x-default del hreflang apunta al inglés. El español no es una traducción de
segunda: es el idioma en el que se escribe el contenido primero. Pero el
público al que llega el sitio desde fuera de República Dominicana busca en
inglés.
El idioma es el primer segmento
Todo el sitio cuelga de app/[locale], y ese segmento tiene el layout raíz,
el que escribe <html>. Eso importa por un motivo concreto: el atributo
lang tiene que estar en el HTML servido, no corregirse después con
JavaScript. Es lo que leen el lector de pantalla y el buscador.
export function generateStaticParams() {
  return PUBLISHED_LOCALES.map((locale) => ({ locale }));
}

// Sólo existen los idiomas publicados: `/fr` o `/xx/contacto` son un 404
// directo, sin renderizarse bajo demanda.
export const dynamicParams = false;
dynamicParams = false hace que cualquier idioma que no esté en la lista sea
un 404 inmediato. Sin esa línea, Next.js intentaría renderizar /fr bajo
demanda y lo guardaría en caché.
Hay un precio: con un layout raíz por idioma, cambiar de idioma recarga el
documento entero. Lo acepté. Es un gesto que se hace una vez por visita, y a
cambio el HTML de cada idioma es correcto desde el primer byte. La otra
consecuencia es que una ruta fuera de cualquier idioma no tiene layout que
pinte su 404; para eso existe app/global-not-found.tsx, que hoy se activa con
experimental.globalNotFound.
Rutas traducidas con una carpeta dinámica
La forma obvia de tener /es/proyectos y /en/projects es crear dos carpetas.
Funciona para una página suelta —la de privacidad tiene privacidad/ y
privacy/, cada una sólo en su idioma—, pero no escala: cada página hija
habría que duplicarla, y con ella el código.
La alternativa habitual, una reescritura (en next.config o en un
middleware), tiene una trampa: usePathname devuelve una ruta en el servidor y
otra en el cliente, y cualquier componente que marque «estás aquí» acaba
desincronizado.
Así que las secciones son un segmento dinámico: app/[locale]/[mundo], con
sus hijos en [mundo]/[sub] y [mundo]/[sub]/[objeto]. El slug de cada
sección vive en el frontmatter de su contenido, en cada idioma:
# content/es/worlds/endurance.mdx
id: endurance
slug: proyectos

# content/en/worlds/endurance.mdx
id: endurance
slug: projects
Las dos versiones se unen por el id, nunca por el slug. Los segmentos que no
son de ninguna sección —servicios/services, gracias/thanks,
observatorio/observatory— están en un módulo aparte, sin dependencias, para
que también los pueda leer el código de cliente:
export const PATH_SEGMENTS = {
  observatory: { es: "observatorio", en: "observatory" },
  thanks: { es: "gracias", en: "thanks" },
  services: { es: "servicios", en: "services" },
  privacy: { es: "privacidad", en: "privacy" },
  blog: { es: "blog", en: "blog" },
} as const satisfies Record<string, Record<Locale, string>>;
Cada página dinámica declara sus generateStaticParams en los dos idiomas y
también lleva dynamicParams = false. El resultado: todo el sitio se genera en
el build y /en/proyectos —el slug español con el idioma inglés— es un 404,
no una página duplicada.
Nombrar páginas, no URLs
Ésta es la pieza que hace que todo lo demás sea fácil. En el código ninguna página se nombra por su ruta. Se nombra por lo que es:
export type PageRef =
  | { kind: "home" }
  | { kind: "world"; id: WorldId }
  | { kind: "project"; id: ProjectId }
  | { kind: "services" }
  | { kind: "observatory"; id: WorldId }
  | { kind: "blog" }
  | { kind: "article"; id: ArticleId }
  | { kind: "privacy" };
Una sola función convierte un PageRef en su ruta para un idioma, y otra
devuelve la misma página en todos los idiomas publicados:
export function pageAlternates(page: PageRef): Record<Locale, string> {
  return Object.fromEntries(
    PUBLISHED_LOCALES.map((locale) => [locale, pagePath(page, locale)]),
  ) as Record<Locale, string>;
}
De esa función beben el selector de idioma, el hreflang de cada página, el
sitemap y los enlaces internos. Nadie arma una URL a mano. Si mañana
/es/proyectos pasara a llamarse /es/trabajo, se cambia una línea de
frontmatter y todo lo demás —incluidos los enlaces de la cabecera y el
sitemap— la sigue.
Como PageRef es una unión discriminada, el switch que la recorre es
exhaustivo: añadir una página nueva sin decir cuál es su ruta es un error de
TypeScript, no un enlace roto en producción.
hreflang y x-default
Sin hreflang, Google ve /es/sobre-mi y /en/about como dos páginas con el
mismo tema y elige una, o las alterna. Con él, sabe que son la misma página y
enseña a cada persona la de su idioma.
La metadata de cada página sale de la misma fuente:
export function pageAlternatesMetadata(page: PageRef, locale: Locale) {
  const alternates = pageAlternates(page);
  return {
    canonical: alternates[locale],
    languages: { ...alternates, "x-default": alternates[DEFAULT_LOCALE] },
  };
}
Cada página dice cuál es su URL canónica —la suya, en su idioma— y declara a
sus hermanas. x-default le dice al buscador qué enseñar a quien no busca en
ninguno de los dos idiomas: el inglés.
Dos detalles que se olvidan con facilidad:
- La relación tiene que ser recíproca. Si la versión inglesa apunta a la española, la española tiene que apuntar a la inglesa. Al salir las dos de la misma función, no pueden discrepar.
- El Open Graph también tiene idioma. Cada página declara
og:locale(en_USoes_DO) y el otro comoog:locale:alternate, para que una vista previa en redes sepa qué es.
El sitemap también lo dice
El buscador lee el sitemap antes de rastrear, así que la relación entre
idiomas va también ahí. Next.js genera el xhtml:link rel="alternate" de cada
entrada a partir de alternates.languages:
export default function sitemap(): MetadataRoute.Sitemap {
  return PAGES.flatMap(({ page, priority, changeFrequency }) => {
    const alternates = pageAlternates(page);
    const languages = Object.fromEntries(
      Object.entries(alternates).map(([locale, path]) => [locale, absoluteUrl(path)]),
    );
    return PUBLISHED_LOCALES.map((locale) => ({
      url: absoluteUrl(alternates[locale]),
      changeFrequency,
      priority,
      alternates: { languages },
    }));
  });
}
Una decisión deliberada: el sitemap no lleva lastModified. Sellar cada
URL con la fecha del build afirmaría un cambio que no ocurrió, y los buscadores
aprenden a ignorar un lastmod que no es fiable.
El selector de idioma son enlaces
El selector EN | ES de la cabecera no es un botón que cambia un estado. Son dos
enlaces <a> a la misma página en el otro idioma:
<a
  href={languages[locale]}
  hrefLang={locale}
  lang={locale}
  aria-current={locale === current ? "true" : undefined}
  onClick={() => {
    document.cookie = `${LANGUAGE_COOKIE}=${locale}; path=/; max-age=31536000; samesite=lax`;
  }}
>
Eso tiene varias ventajas que un botón no tiene: funciona sin JavaScript, se puede abrir en otra pestaña, el buscador lo sigue y el lector de pantalla lo anuncia como lo que es. Su nombre accesible es el nombre del idioma en ese idioma —«English», «Español»—, que es como se reconoce.
Son <a> y no <Link> de Next.js a propósito: cambiar de idioma cambia de
layout raíz, y Next.js recargaría el documento de todos modos. Un <Link> sólo
añadiría una precarga inútil.
La raíz: un redirect, no un middleware
Lo único que JavaScript añade al selector es recordar la elección en una
cookie. ¿Para qué? Para la raíz. Quien eligió español y vuelve a entrar por
jonasjavier.dev debería caer en español. Eso se resuelve con dos redirects
estáticos en next.config.ts, sin middleware:
async redirects() {
  return [
    {
      source: "/",
      has: [{ type: "cookie", key: LANGUAGE_COOKIE, value: "es" }],
      destination: "/es",
      permanent: false,
    },
    { source: "/", destination: "/en", permanent: false },
  ];
}
Los dos son temporales (307): la raíz no se ha mudado, sólo depende de una
preferencia. Y no se mira Accept-Language por las mismas razones del
principio: una portada que cambia según quién pregunte no se puede cachear ni
enlazar con seguridad, y el buscador siempre ve la inglesa, que es la que
x-default declara.
Sin middleware no hay código ejecutándose antes de cada petición, y las páginas se siguen generando en el build.
El texto de la interfaz, junto a su componente
Hay dos clases de texto. El contenido —la prosa de cada sección, los casos
de estudio, estas entradas— vive en content/es y content/en como MDX, y lo
compila Velite. El texto de interfaz —botones, etiquetas, estados— vive en
el propio componente, en un objeto con los dos idiomas:
export function defineCopy<T>(table: { es: T; en: NoInfer<T> }): Record<Locale, T> {
  return table;
}

const COPY = defineCopy({
  es: { label: "Idioma" },
  en: { label: "Language" },
});
NoInfer es la parte importante. Sin él, TypeScript inferiría el tipo de la
unión de los dos objetos y una clave olvidada en inglés pasaría. Con él, el
tipo lo fija el español y el inglés tiene que cumplirlo: falta una clave, falla
el typecheck.
Para el contenido, la garantía está en el build. Velite comprueba que cada pieza existe exactamente una vez en cada idioma publicado y que dos piezas no comparten slug en el mismo idioma. Si falta la traducción de una sección, el sitio no se publica.
Lo que no se traduce palabra por palabra
Los títulos y las descripciones en inglés no son una traducción de los españoles: están escritos para búsquedas en inglés. «Desarrollador full-stack en República Dominicana» no se convierte en «Developer full-stack in Dominican Republic»: en inglés se busca «Full-Stack Developer», y en un orden distinto.
Los datos estructurados siguen la misma lógica: la persona que firma el sitio
tiene un solo @id en los dos idiomas —es la misma persona— pero su cargo y su
descripción van en el idioma de la página.
Cómo se prueba
Una suite de Playwright recorre lo que se puede romper: que la raíz lleve al
inglés y, con la cookie, al español; que cada pareja de rutas tenga su lang,
su canónica y su hreflang cruzados; que una ruta de un idioma sea un 404 en
el otro; que el selector lleve a la misma página y recuerde la elección; que
las páginas en inglés hablen inglés, y que el formulario de contacto valide en
el idioma de la página. Y una prueba unitaria exige que todo enlace interno de
estas entradas apunte a una página que existe, en el idioma de la entrada.
Pruébalo
Cambia de idioma en la cabecera desde cualquier página: llegas a la misma página en el otro idioma, no a la portada. Si estás construyendo algo que necesita hablar dos idiomas, aquí cuento cómo trabajo. Y si te interesa la parte 3D del sitio, empieza por el agujero negro.